Web Search Agents by Nimble
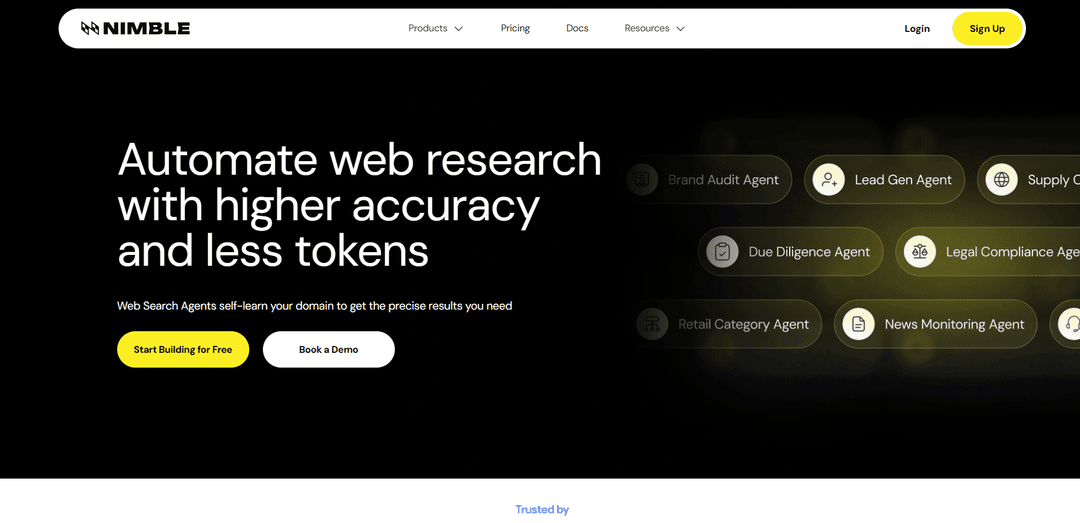
NimbleのWeb Search Agentsは、自己学習型でドメインに特化したWeb取得エージェントであり、ライブWeb上で監査可能な検索計画を実行し、トークンの無駄を削減し、時間の経過とともに精度を向上させながら、検証済みでスキーマに一貫性のある構造化された結果を返します。
https://nimbleway.com/web-search-agents?ref=producthunt&utm_source=aipure
製品情報
更新日:2026年09月21日
Web Search Agents by Nimbleとは
NimbleのWeb Search Agentsは、AIエージェントおよび公開Webから新鮮で信頼性の高い情報を必要とする本番ワークフロー向けに構築された、エキスパートレベルのWeb検索および取得システムです。一般的な「ブルーリンク」や長い非構造化ページダンプを返す代わりに、Nimbleはタスクとスキーマに合わせた構造化された分析準備済みの出力(例:JSON/CSV/Markdown)を提供するように設計されています。この製品は、超特異的な調査ワークフロー、データセットの構築/エンリッチメント、Webページ上の変更の継続的な監視などの複雑なユースケースを対象としており、ガバナンス、信頼性、および下流のLLM推論のための費用対効果の高い取得に重点を置いています。
Web Search Agents by Nimbleの主な機能
Nimble Web Search Agentsは、自己学習型でドメイン適応型のウェブ検索エージェントであり、リアルタイムでライブウェブを閲覧し、本番AIワークフロー向けに構造化され、引用され、信頼度評価された出力を返します。これらは、超特異的な調査ワークフローを実行し、一貫したスキーマでデータセットを構築および拡充し、ウェブページの変化を継続的に監視するように設計されています。同時に、何が、どこで、なぜ検索されたかを示す監査可能な検索計画を通じて、エンタープライズガバナンスを提供します。このシステムは、鮮度(キャッシュされたインデックスではなくライブページアクセス)、検索とクロールを組み合わせたサブページへの深いアクセス、フィールド化された出力(JSON/Markdown/CSV)によるトークン効率、および動的または保護されたサイトでのスケーラブルで信頼性の高い実行を重視しています。
自己学習型、ドメイン適応型エージェント: エージェントは独自のインデックス/メモリを通じて時間の経過とともにドメイン知識を蓄積し、検索品質を向上させ、特定の調査タスクのスペシャリストになります。
深いアクセスを伴うライブウェブブラウジング: リクエスト時にライブインターネットをクエリし(キャッシュされた結果だけでなく)、検索とドメインクロールを組み合わせて、表面レベルのSERPリンクを超えたより深いサブページや隠れたコンテンツに到達できます。
構造化された、エージェント対応の出力: JSON/Markdown/CSVなどの形式でクリーンでスキーマ一貫性のあるデータを返し、抽出された情報をフィールドに分類して解析オーバーヘッドとトークン使用量を削減します。
監査可能なガバナンスと制御: ガードレールと、何が、どこで、なぜ検索されたかを正確に文書化する監査可能な検索計画により、検索方法論を完全に制御し、透明性とコンプライアンスをサポートします。
データセットの構築と拡充ワークフロー: チームがスキーマを定義し、拡充、発見、レポート作成のために一貫した結果を繰り返し生成できるようにします。これにより、ウェブページを分析パイプラインに適したキュレーションされたテーブルに変換します。
ウェブ変更の継続的な監視(ベータ版): 任意のウェブページ上の特定のデータポイントをほぼリアルタイムで追跡し、スクレイパーを再構築することなく変更検出と継続的なインテリジェンスを可能にします。
Web Search Agents by Nimbleのユースケース
企業および市場調査の自動化: 市場分析ワークフロー向けに、引用され、構造化され、信頼度評価された、下流分析に適した企業レポート、拡充、および発見出力を生成します。
不動産インテリジェンスと拡充: ライブウェブの鮮度と構造化された抽出を活用し、不動産レポート作成および監視タスクのために、プロパティ/市場シグナルを収集および正規化し、再現可能な出力を提供します。
ソーシャルメディア監視とシグナルキャプチャ: ソーシャルプラットフォームおよび広範なウェブ全体での言及、トレンド、更新を追跡し、アラート、ダッシュボード、またはアナリストワークフローに供給できる構造化された監視出力を生成します。
旅行およびホスピタリティの調査と監視: 動的なサイト全体で旅行/ホスピタリティのデータポイント(例:リスティング、ポリシー、レビュー、空室状況シグナル)を集約および監視し、分析用の構造化された結果を返します。
金融および投資インテリジェンス: 鮮度が意思決定に影響を与える調査および監視ワークフローをサポートするために、リアルタイムの代替ウェブシグナル(センチメント、採用、ローンチ、ガイダンスと実績)を抽出します。
製品およびデジタルシェルフインテリジェンス: GTMおよび価格設定ワークフローのために、一貫した製品シグナルをテーブルに抽出することで、品揃えのギャップを特定し、MAP違反を監視し、販売者/小売業者全体での製品の存在を追跡します。
メリット
鮮度優先の検索:ライブウェブを閲覧するため、結果はキャッシュされたスナップショットではなく現在のページの状態を反映します。
本番指向の出力:引用/信頼度評価付きの構造化されたスキーマ一貫性のあるデータは、下流のクリーンアップとトークンコストを削減します。
ガバナンスと透明性:監査可能な検索計画と制御可能な方法論は、エンタープライズ要件をサポートします。
複雑なサイトへのスケーリング:JavaScriptを多用する/保護されたページや大規模な並列ワークロード向けに設計されたインフラストラクチャ。
デメリット
最大の価値を得るためには、スキーマ、ガードレール、ドメイン固有のワークフローを定義するための設定と反復が必要な場合があります。
一部の機能(例:継続的な監視)はベータ版とされており、潜在的な制限や動作の変更を示唆しています。
他のライブウェブシステムと同様に、パフォーマンスと完全性は、サイトの変更、アクセス制限、または地域的な可用性の制約によって影響を受ける可能性があります。
Web Search Agents by Nimbleの使い方
1) Web Search Agentのユースケースを選択する: エージェントに何をさせたいかを決定します。(a) 超特異的な調査ワークフローを実行する、(b) 一貫したスキーマでデータセットを構築/エンリッチする、または (c) Webページの変化をリアルタイムで監視する(ベータ版)。この選択により、エージェントに何を検索させるか、および出力をどのように構造化するかが決まります。
2) Nimbleアカウントを作成し、APIキーを取得する: Nimbleにサインアップ/ログインし、APIキーを生成します。このキーをNimble SDK/CLIで使用して、検索を実行し、(必要に応じて)抽出を行います。
3) Nimble SDK (Python) をインストールし、APIキーを設定する: Nimble Pythonパッケージをインストールし、環境変数NIMBLE_API_KEYを設定します。次に、コード内でクライアントを初期化します(例:Nimble(api_key=os.environ["NIMBLE_API_KEY"]))。これにより、エージェントはNimbleのWeb Search APIを呼び出すことができます。
4) 最初のWeb検索クエリを実行する(構造化された結果): nimble.search(query=..., max_results=...) を呼び出して、エージェントワークフロー用にすでに構造化されているライブWeb結果(深さによってタイトル/URL/スニペットおよびより豊富なフィールド)を取得します。これにより、生HTMLをLLMに送信することを避け、トークン使用量を削減できます。
5) 検索の深さモードを選択する(lite / fast / deep): タスクに合った深さを使用します。liteはタイトル/URL/スニペットを返します。fastはAIエージェントワークフロー用に最適化されたより豊富なコンテンツを返します(マルチ検索調査エージェントの推奨デフォルト)。deepは包括的なデューデリジェンススタイルの取得のために完全なリアルタイムページ抽出を実行します。
6) 新鮮度で結果をフィルタリングする(オプションですが、監視/ニュースには推奨): time_range(例:「week」)または明示的なstart_date/end_dateを使用して、結果を関心のある時間枠に制限します。これは、ニュース監視、最近の動向の追跡、または履歴分析に役立ちます。
7) フォーカスモードを使用して取得するものを制限する(オプション): Nimbleフォーカスモードを選択して、エージェントがWebから取得するものを制御します。これにより、必要なデータだけを正確に取得し、不要なものを除外します。これにより、関連性が向上し、必要なものだけを取得することでトークン/コストがさらに削減されます。
8) 反復可能なデータセット構築のための出力スキーマを定義する(データセット/エンリッチメントワークフロー): データセットの構築またはエンリッチメントが目標である場合、返されるスキーマを定義して、各実行が一貫した構造化された出力を生成するようにします。これは、多くのエンティティ/ページ間で安定したフィールドを必要とするパイプラインの推奨パターンです。
9) Web Search AgentsをLLMエージェントに統合する(LangChainの例): Nimble検索をツール関数(例:web_search(query) -> 形式化された結果)でラップし、エージェントにアタッチします。LangChainでは、ツールベースのエージェントを作成し、LLMが実行中にNimbleをバックエンドとするweb_searchツールを呼び出して、ライブWebデータに基づいて回答を根拠付けることができます。
10) 最終出力で引用/URLを証拠として使用する: エージェントに、主張の裏付けとなる証拠として、返されたURL(および要約/フィールド)を含めるようにします。これにより、出力の監査可能性が保たれ、検証が容易になります。
11) 監査可能な検索計画によるガバナンスを有効にする(本番環境の強化): 本番ワークフローでは、Nimbleの監査可能な検索計画に依存して、何が、どこで、なぜ検索されたかを正確に追跡します。これは、エージェントの動作のガバナンス、デバッグ、およびコンプライアンスレビューをサポートします。
12) Web上の変更の監視を追加する(ベータ版): 継続的な追跡のために、特定のWebページ/データポイントの取得を定期的に再実行し、時間の経過とともに結果を比較するワークフローを構成します。新鮮度フィルターと構造化フィールドを使用して、変更を確実に検出し、下流のアクションをトリガーします。
13) スケールアップ:多くの検索を効率的に実行し、コストを削減する: 複数検索の実行では、デフォルトで高速深度を優先し、max_resultsを本当に必要なものに制限し、冗長な検索を避けます。Nimbleは、LLM解析を必要とする生のページではなく、エージェント対応の構造化データを返すことでトークンコストを削減するように設計されています。
14) (オプション) Nimble Searchを他のエージェントフレームワーク/ツールに接続する: 他のオーケストレーションレイヤーを使用している場合は、Nimbleを検索プロバイダーとして使用するように構成します(サポートされている場合)。これにより、そのエージェント内のすべてのモデルが、アンチボット処理やJavaScriptレンダリングを含むNimbleの検索APIを通じてライブWeb結果にアクセスできます。
Web Search Agents by Nimbleのよくある質問
Web検索エージェントは、目的に合わせて構築された自己学習型のWeb検索エージェントで、ライブインターネットを照会し、それをAIと分析のための構造化された信頼性の高いデータに変換します。これらは、超特異的な調査ワークフローを実行し、データセットを構築/強化し、Webページの変更を監視するように設計されています。
Web Search Agents by Nimbleに類似した最新のAIツール
Jorpex
Jorpexは、ヨーロッパ各国からの即時入札アラートを集約し、Slackに直接配信する包括的な入札通知プラットフォームであり、企業が機会を逃さないようにします
Leadsmrt
Leadsmrtは、企業がGoogleマップからターゲットビジネスリードをスクレイピング、検証、パーソナライズするのを支援するリード生成ツールで、AI駆動のパーソナライズ機能を備えています。
Omnial AI
Omnial AIは、AIエージェントを活用してウェブプロンプトを構造化された実行可能なデータ洞察に変換するデータインテリジェンスプラットフォームで、Afore Capitalに支援されています。
SERPrecon
SERPreconは、ベクトル、機械学習、自然言語処理を活用して、ユーザーが競合を分析し、現代の検索エンジンと同じ手法を使用して競合を上回るのを支援する高度なSEOツールです。
Web Search Agents by Nimbleに似た人気のAIツール
Magentic-UI
Magentic-UI は、Microsoft Research によるオープンソースの人間中心のウェブエージェントプロトタイプであり、人間と AI エージェント間の透過的なインタラクションを通じて、複雑なウェブベースのタスクの共同計画と実行を可能にします。
Web Accessibility Testing MCP
A11y MCP is a Model Context Protocol server that enables AI language models to perform automated web accessibility testing by integrating with Deque's Axe-core API and Puppeteer to analyze web content for WCAG compliance.
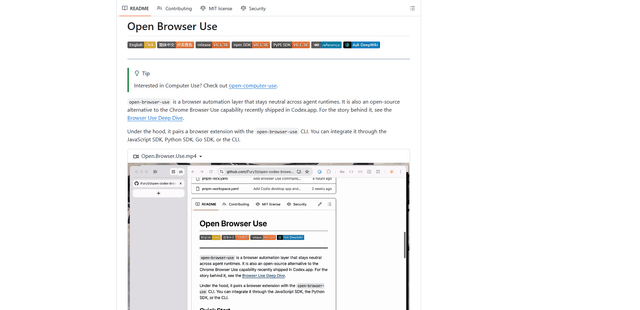
Open Browser Use
Open Browser Useは、オープンソースでエージェントランタイムに依存しないブラウザ自動化レイヤーであり、Chrome拡張機能とCLI/SDK/MCPを組み合わせて、DOM認識型でCDP駆動のタブ制御、ナビゲーション、およびさまざまなAIエージェントツール全体でのアクションを可能にします。
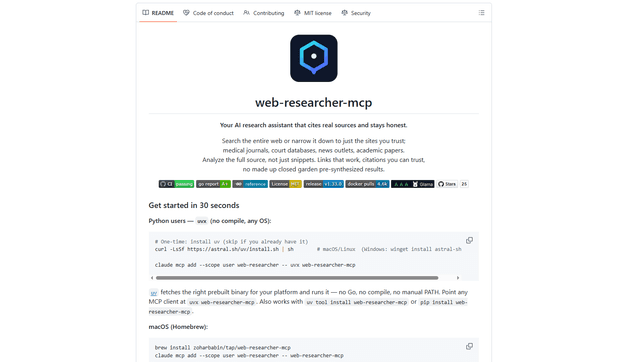
Web Researcher MCP
Web Researcher MCPは、AIアシスタントがウェブを検索し(オプションで信頼できる「検索レンズ」に限定)、完全な情報源(JSレンダリングされたページ、PDF、YouTubeトランスクリプトを含む)を読み取り、マルチプロバイダーフェイルオーバーで検証可能な引用を返すことができる、ローカルで本番環境対応のMCPサーバーです。 [出典: https://github.com/zoharbabin/web-researcher-mcp?ref=producthunt]