Web Search Agents by Nimble
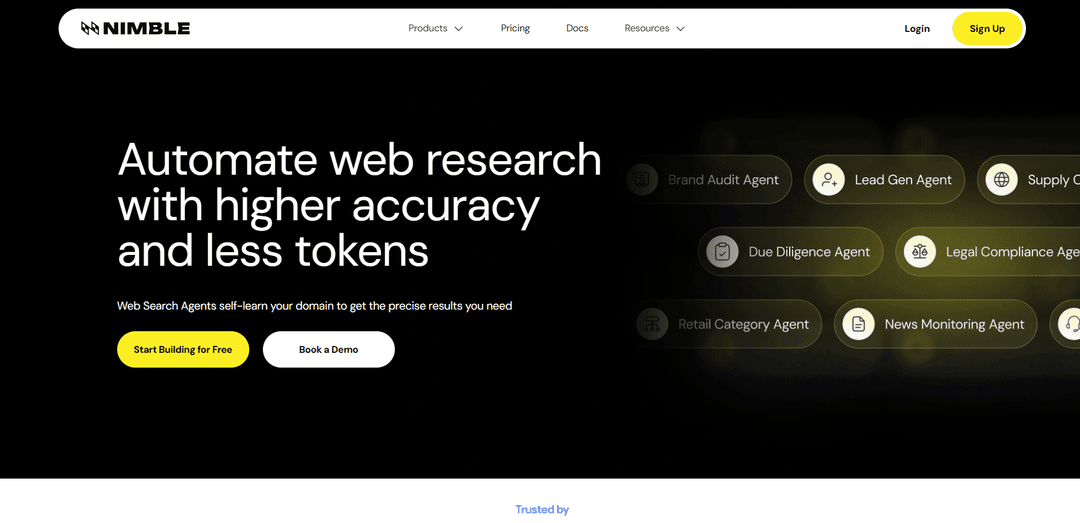
Les agents de recherche Web de Nimble sont des agents de récupération Web auto-apprenants et spécialisés dans un domaine qui exécutent des plans de recherche auditables sur le Web en direct et renvoient des résultats structurés validés et cohérents avec le schéma, tout en réduisant le gaspillage de jetons et en améliorant la précision au fil du temps.
https://nimbleway.com/web-search-agents?ref=producthunt&utm_source=aipure
Informations sur le produit
Mis à jour:Sep 21, 2026
Qu'est-ce que Web Search Agents by Nimble
Les agents de recherche Web de Nimble sont un système de recherche et de récupération Web de niveau expert conçu pour les agents d'IA et les flux de travail de production qui ont besoin d'informations fraîches et fiables provenant du Web public. Au lieu de renvoyer des "liens bleus" génériques ou de longs "dumps" de pages non structurés, Nimble est conçu pour fournir des sorties structurées et prêtes à l'analyse (par exemple, JSON/CSV/Markdown) alignées sur votre tâche et votre schéma. Le produit cible les cas d'utilisation complexes tels que les flux de travail de recherche hyper-spécifiques, la création/l'enrichissement de jeux de données et la surveillance continue des changements sur les pages Web, en mettant l'accent sur la gouvernance, la fiabilité et la récupération rentable pour le raisonnement LLM en aval.
Caractéristiques principales de Web Search Agents by Nimble
Les agents de recherche web Nimble sont des agents de récupération web auto-apprenants et adaptatifs au domaine qui parcourent le web en temps réel et renvoient des résultats structurés, cités et classés par niveau de confiance pour les flux de travail d'IA de production. Ils sont conçus pour exécuter des flux de travail de recherche hyper-spécifiques, construire et enrichir des ensembles de données avec des schémas cohérents, et surveiller en continu les pages web pour détecter les changements, tout en assurant la gouvernance d'entreprise grâce à des plans de recherche auditables qui montrent ce qui a été recherché, où et pourquoi. Le système met l'accent sur la fraîcheur (accès aux pages en direct vs index mis en cache), l'accès profond aux sous-pages via une combinaison de recherche et de crawling, l'efficacité des jetons grâce à des sorties structurées (JSON/Markdown/CSV), et une exécution évolutive et fiable sur des sites dynamiques ou protégés.
Agents auto-apprenants et adaptatifs au domaine: Les agents accumulent des connaissances du domaine au fil du temps via un index/mémoire propriétaire, améliorant la qualité de la récupération et devenant des spécialistes pour votre tâche de recherche spécifique.
Navigation web en direct avec accès profond: Interroge l'internet en direct au moment de la requête (pas seulement les résultats mis en cache) et peut combiner la recherche avec le crawling de domaine pour atteindre des sous-pages plus profondes et du contenu caché au-delà des liens SERP de surface.
Sorties structurées et prêtes pour l'agent: Renvoie des données propres et cohérentes avec le schéma dans des formats tels que JSON/Markdown/CSV, catégorisant les informations extraites en champs pour réduire les frais généraux d'analyse et l'utilisation des jetons.
Gouvernance et contrôle auditables: Offre un contrôle total sur la méthodologie de recherche avec des garde-fous et des plans de recherche auditables qui documentent exactement ce qui a été recherché, où et pourquoi – soutenant la transparence et la conformité.
Flux de travail de création et d'enrichissement de jeux de données: Permet aux équipes de définir un schéma et de générer de manière répétée des résultats cohérents pour l'enrichissement, la découverte et le reporting – transformant les pages web en tableaux organisés adaptés aux pipelines d'analyse.
Surveillance continue des changements web (bêta): Suit des points de données spécifiques sur n'importe quelle page web en temps quasi réel, permettant la détection des changements et l'intelligence continue sans reconstruire les scrapers.
Cas d'utilisation de Web Search Agents by Nimble
Automatisation de la recherche d'entreprise et de marché: Générez des rapports d'entreprise, des enrichissements et des découvertes pour les flux de travail d'analyse de marché, en utilisant des résultats cités, structurés et classés par niveau de confiance, adaptés à l'analyse en aval.
Intelligence et enrichissement immobilier: Collectez et normalisez les signaux de propriété/marché pour les tâches de reporting et de surveillance immobilière, en tirant parti de la fraîcheur du web en direct et de l'extraction structurée pour des résultats reproductibles.
Surveillance des médias sociaux et capture de signaux: Suivez les mentions, les tendances et les mises à jour sur les plateformes sociales et le web en général, en produisant des résultats de surveillance structurés qui peuvent alimenter les alertes, les tableaux de bord ou les flux de travail des analystes.
Recherche et surveillance du voyage et de l'hôtellerie: Agrègez et surveillez les points de données de voyage/hôtellerie (par exemple, listes, politiques, avis, signaux de disponibilité) sur des sites dynamiques, en renvoyant des résultats structurés pour l'analyse.
Intelligence financière et d'investissement: Extrayez des signaux web alternatifs en temps réel (sentiment, embauches, lancements, prévisions vs réels) pour soutenir les flux de travail de recherche et de surveillance où la fraîcheur affecte les décisions.
Intelligence produit et étagère numérique: Identifiez les lacunes d'assortiment, surveillez les violations MAP et suivez la présence des produits chez les vendeurs/détaillants en extrayant des signaux de produits cohérents dans des tableaux pour les flux de travail GTM et de tarification.
Avantages
Récupération axée sur la fraîcheur : parcourt le web en direct afin que les résultats reflètent l'état actuel de la page plutôt que des instantanés mis en cache.
Sorties orientées production : les données structurées et cohérentes avec le schéma, avec des citations/classement de confiance, réduisent le nettoyage en aval et les coûts de jetons.
Gouvernance et transparence : les plans de recherche auditables et les méthodologies contrôlables répondent aux exigences de l'entreprise.
S'adapte aux sites complexes : infrastructure conçue pour les pages lourdes en JavaScript/protégées et les grandes charges de travail parallèles.
Inconvénients
Peut nécessiter une configuration et une itération pour définir les schémas, les garde-fous et les flux de travail spécifiques au domaine afin d'obtenir une valeur maximale.
Certaines fonctionnalités (par exemple, la surveillance continue) sont étiquetées bêta, ce qui implique des limitations potentielles ou un comportement évolutif.
Comme tout système web en direct, les performances et l'exhaustivité peuvent être affectées par les changements de site, les restrictions d'accès ou les contraintes de disponibilité régionale.
Comment utiliser Web Search Agents by Nimble
1) Choisissez votre cas d'utilisation d'agent de recherche Web: Décidez ce que vous voulez que l'agent fasse : (a) exécuter des flux de travail de recherche hyper-spécifiques, (b) créer/enrichir des jeux de données avec un schéma cohérent, ou (c) surveiller les pages Web pour les changements en temps réel (bêta). Ce choix détermine ce que vous demanderez à l'agent de récupérer et comment vous structurerez les sorties.
2) Créez un compte Nimble et obtenez une clé API: Inscrivez-vous/connectez-vous à Nimble et générez une clé API. Vous utiliserez cette clé avec le SDK/CLI Nimble pour exécuter des recherches et (si nécessaire) l'extraction.
3) Installez le SDK Nimble (Python) et définissez votre clé API: Installez le package Python Nimble et définissez la variable d'environnement NIMBLE_API_KEY. Ensuite, initialisez le client dans le code (par exemple, Nimble(api_key=os.environ["NIMBLE_API_KEY"])) afin que votre agent puisse appeler l'API de recherche Web de Nimble.
4) Exécutez votre première requête de recherche Web (résultats structurés): Appelez nimble.search(query=..., max_results=...) pour récupérer des résultats Web en direct qui sont déjà structurés pour les flux de travail des agents (titres/URL/extraits et champs plus riches selon la profondeur). Cela évite d'envoyer du HTML brut dans un LLM et réduit l'utilisation des jetons.
5) Choisissez un mode de profondeur de recherche (lite / fast / deep): Utilisez la profondeur qui correspond à votre tâche : lite renvoie les titres/URL/extraits ; fast renvoie un contenu plus riche optimisé pour les flux de travail des agents d'IA (recommandé par défaut pour les agents de recherche multi-recherches) ; deep effectue une extraction complète de la page en temps réel pour une récupération complète de type diligence raisonnable.
6) Filtrez les résultats par date de publication (facultatif mais recommandé pour la surveillance/les actualités): Utilisez time_range (par exemple, "week") ou des start_date/end_date explicites pour limiter les résultats à la période qui vous intéresse, utile pour la surveillance des actualités, le suivi des développements récents ou l'analyse historique.
7) Limitez ce qui est récupéré à l'aide des modes de focus (facultatif): Sélectionnez les modes de focus Nimble pour contrôler ce que votre agent extrait du Web, en ciblant les données exactes que vous souhaitez et en excluant ce que vous ne voulez pas. Cela améliore la pertinence et réduit davantage les jetons/coûts en ne récupérant que ce qui est nécessaire.
8) Définissez un schéma de sortie pour la création de jeux de données reproductibles (flux de travail de jeu de données/enrichissement): Lorsque votre objectif est la création ou l'enrichissement de jeux de données, définissez le schéma que vous souhaitez voir renvoyé afin que chaque exécution produise des sorties cohérentes et structurées. C'est le modèle recommandé pour les pipelines qui ont besoin de champs stables sur de nombreuses entités/pages.
9) Intégrez les agents de recherche Web dans un agent LLM (exemple LangChain): Enveloppez la recherche Nimble dans une fonction d'outil (par exemple, web_search(query) -> résultats formatés) et attachez-la à votre agent. Dans LangChain, vous pouvez créer un agent basé sur des outils et demander au LLM d'appeler l'outil web_search basé sur Nimble pendant l'exécution pour fonder les réponses sur des données Web en direct.
10) Utilisez les citations/URL comme preuves dans votre sortie finale: Demandez à votre agent d'inclure les URL renvoyées (et les résumés/champs) comme preuves à l'appui de toute affirmation. Cela rend les sorties auditables et plus faciles à vérifier.
11) Activez la gouvernance via des plans de recherche auditables (durcissement de la production): Dans les flux de travail de production, fiez-vous aux plans de recherche auditables de Nimble pour suivre exactement ce qui a été recherché, où et pourquoi. Cela prend en charge la gouvernance, le débogage et l'examen de la conformité du comportement de l'agent.
12) Ajoutez une surveillance des changements sur le Web (bêta): Pour un suivi continu, configurez un flux de travail qui réexécute périodiquement la récupération pour des pages Web/points de données spécifiques et compare les résultats au fil du temps. Utilisez des filtres de date de publication et des champs structurés pour détecter les changements de manière fiable et déclencher des actions en aval.
13) Mise à l'échelle : exécutez de nombreuses recherches efficacement et réduisez les coûts: Pour les exécutions multi-recherches, préférez la profondeur rapide par défaut, limitez max_results à ce dont vous avez vraiment besoin et évitez les recherches redondantes. Nimble est conçu pour réduire les coûts de jetons en renvoyant des données structurées prêtes pour l'agent plutôt que des pages brutes qui nécessitent une analyse LLM.
14) (Facultatif) Connectez Nimble Search à d'autres frameworks/outils d'agent: Si vous utilisez d'autres couches d'orchestration, configurez-les pour utiliser Nimble comme fournisseur de recherche (là où c'est pris en charge) afin que chaque modèle de cet agent puisse accéder aux résultats Web en direct via l'API de recherche de Nimble, y compris la gestion anti-bot et le rendu JavaScript.
FAQ de Web Search Agents by Nimble
Les agents de recherche web sont des agents de récupération web auto-apprenants et spécialement conçus qui interrogent l'internet en direct et le transforment en données structurées et fiables pour l'IA et l'analyse. Ils sont conçus pour exécuter des flux de travail de recherche hyper-spécifiques, construire/enrichir des ensembles de données et surveiller les pages web pour détecter les changements.
Vidéo de Web Search Agents by Nimble
Articles populaires
Atoms : Une plateforme d'IA multi-agents qui transforme les idées en produits prêts à être lancés
May 22, 2026
Nano Banana SBTI : Qu'est-ce que c'est, comment ça marche et comment l'utiliser en 2026
Apr 15, 2026
Atoms : L'outil de création de produits IA qui redéfinit la création numérique en 2026
Apr 10, 2026
Kilo Claw : Comment déployer et utiliser un véritable agent d'IA "Faites-le pour vous" (Mise à jour 2026)
Apr 3, 2026
Derniers outils d'IA similaires à Web Search Agents by Nimble
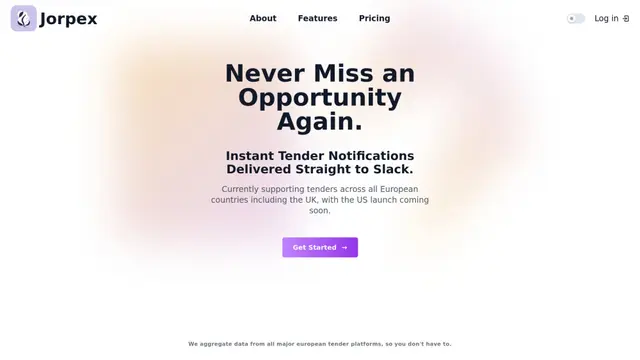
Jorpex
Jorpex est une plateforme complète de notification d'appel d'offres qui agrège et livre des alertes d'appel d'offres instantanées provenant de pays européens directement à Slack, aidant les entreprises à ne jamais manquer d'opportunités.
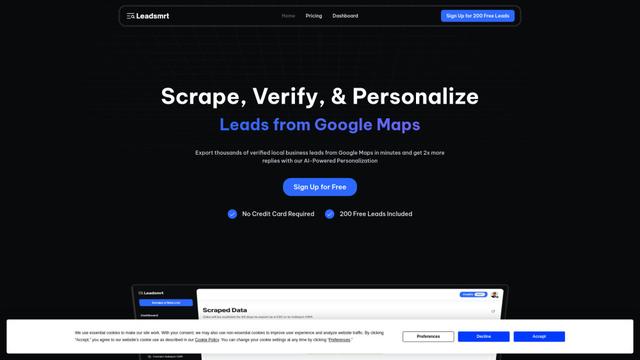
Leadsmrt
Leadsmrt est un outil de génération de leads qui aide les entreprises à scraper, vérifier et personnaliser des leads commerciaux ciblés à partir de Google Maps avec des capacités de personnalisation alimentées par l'IA.
Omnial AI
Omnial AI est une plateforme d'intelligence des données qui exploite des agents IA pour transformer des invites web en informations de données structurées et exploitables soutenues par Afore Capital.
SERPrecon
SERPrecon est un outil SEO avancé qui exploite les vecteurs, l'apprentissage automatique et le traitement du langage naturel pour aider les utilisateurs à analyser et à surpasser leurs concurrents en utilisant les mêmes méthodes que les moteurs de recherche modernes.
Outils d'IA populaires comme Web Search Agents by Nimble
Magentic-UI
Magentic-UI est un prototype d'agent web open source, centré sur l'humain, de Microsoft Research qui permet la planification et l'exécution collaboratives de tâches complexes basées sur le web grâce à une interaction transparente entre les humains et les agents d'IA.
Web Accessibility Testing MCP
A11y MCP est un serveur Model Context Protocol qui permet aux modèles de langage d'IA d'effectuer des tests d'accessibilité web automatisés en s'intégrant à l'API Axe-core de Deque et à Puppeteer pour analyser le contenu web afin de vérifier la conformité WCAG.
Open Browser Use
Open Browser Use est une couche d'automatisation de navigateur open-source, neutre vis-à-vis de l'environnement d'exécution des agents, qui associe une extension Chrome à une CLI/SDK/MCP pour permettre un contrôle des onglets, une navigation et des actions basés sur le DOM et alimentés par le CDP, à travers différents outils d'agents IA.
Web Researcher MCP
Web Researcher MCP est un serveur MCP local de qualité production qui permet aux assistants IA de rechercher sur le web (éventuellement restreint à des « lentilles de recherche » fiables), de lire des sources complètes (y compris des pages rendues en JS, des PDF et des transcriptions YouTube), et de renvoyer des citations vérifiables avec basculement multi-fournisseurs. [Source: https://github.com/zoharbabin/web-researcher-mcp?ref=producthunt]