Web Search Agents by Nimble
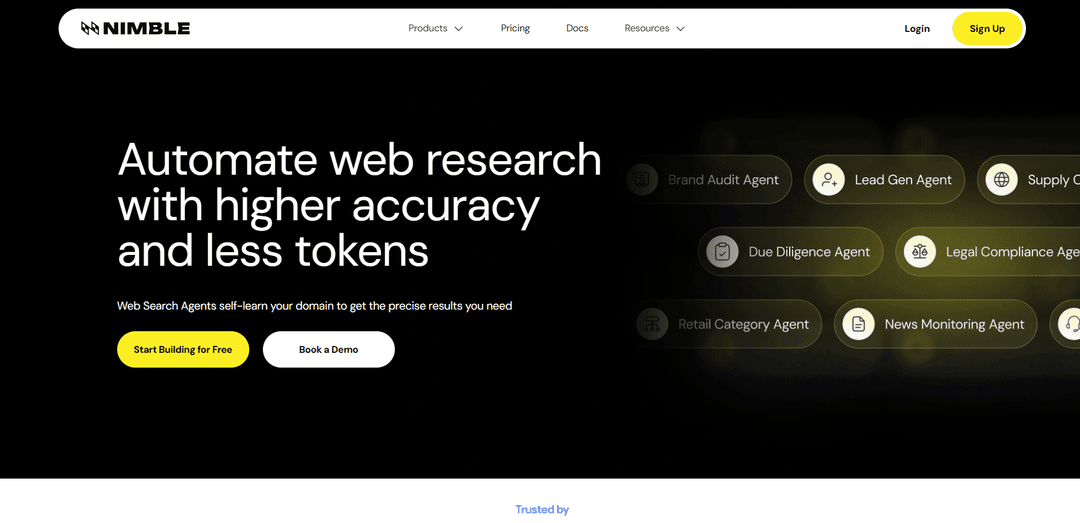
Los Agentes de Búsqueda Web de Nimble son agentes de recuperación web autoaprendizaje y especializados en el dominio que ejecutan planes de búsqueda auditables en la web en vivo y devuelven resultados estructurados validados y consistentes con el esquema, al tiempo que reducen el desperdicio de tokens y mejoran la precisión con el tiempo.
https://nimbleway.com/web-search-agents?ref=producthunt&utm_source=aipure
Información del Producto
Actualizado:21/09/2026
¿Qué es Web Search Agents by Nimble?
Los Agentes de Búsqueda Web de Nimble son un sistema de búsqueda y recuperación web de nivel experto creado para agentes de IA y flujos de trabajo de producción que necesitan información fresca y confiable de la web pública. En lugar de devolver "enlaces azules" genéricos o volcados de páginas largos y no estructurados, Nimble está diseñado para entregar resultados estructurados y listos para el análisis (por ejemplo, JSON/CSV/Markdown) alineados con su tarea y esquema. El producto se dirige a casos de uso complejos como flujos de trabajo de investigación hiperespecíficos, construcción/enriquecimiento de conjuntos de datos y monitoreo continuo de cambios en páginas web, con un énfasis en la gobernanza, la confiabilidad y la recuperación rentable para el razonamiento de LLM posterior.
Características Principales de Web Search Agents by Nimble
Los Agentes de Búsqueda Web Ágiles son agentes de recuperación web autoaprendizaje y adaptables al dominio que navegan por la web en tiempo real y devuelven resultados estructurados, citados y con calificación de confianza para flujos de trabajo de IA de producción. Están diseñados para ejecutar flujos de trabajo de investigación hiperespecíficos, construir y enriquecer conjuntos de datos con esquemas consistentes, y monitorear continuamente las páginas web en busca de cambios, al tiempo que proporcionan gobernanza empresarial a través de Planes de Búsqueda auditables que muestran qué se buscó, dónde y por qué. El sistema enfatiza la frescura (acceso a páginas en vivo frente a índices en caché), el acceso profundo a subpáginas a través de la combinación de búsqueda + rastreo, la eficiencia de tokens a través de salidas con campos (JSON/Markdown/CSV), y la ejecución escalable y confiable en sitios dinámicos o protegidos.
Agentes autoaprendizaje y adaptables al dominio: Los agentes acumulan conocimiento del dominio con el tiempo a través de un índice/memoria propietario, mejorando la calidad de la recuperación y convirtiéndose en especialistas para su tarea de investigación específica.
Navegación web en vivo con acceso profundo: Consulta la internet en vivo en el momento de la solicitud (no solo resultados en caché) y puede combinar la búsqueda con el rastreo de dominio para llegar a subpáginas más profundas y contenido oculto más allá de los enlaces SERP a nivel de superficie.
Salidas estructuradas y listas para agentes: Devuelve datos limpios y consistentes con el esquema en formatos como JSON/Markdown/CSV, categorizando la información extraída en campos para reducir la sobrecarga de análisis y el uso de tokens.
Gobernanza y control auditables: Proporciona control total sobre la metodología de búsqueda con barandillas y Planes de Búsqueda auditables que documentan exactamente qué se buscó, dónde y por qué, apoyando la transparencia y el cumplimiento.
Flujos de trabajo de construcción y enriquecimiento de conjuntos de datos: Permite a los equipos definir un esquema y generar repetidamente resultados consistentes para enriquecimiento, descubrimiento e informes, convirtiendo páginas web en tablas curadas adecuadas para pipelines de análisis.
Monitoreo continuo de cambios web (beta): Rastrea puntos de datos específicos en cualquier página web casi en tiempo real, lo que permite la detección de cambios y la inteligencia continua sin reconstruir los "scrapers".
Casos de Uso de Web Search Agents by Nimble
Automatización de investigación de empresas y mercados: Genere informes de empresas, enriquecimiento y resultados de descubrimiento para flujos de trabajo de análisis de mercado, utilizando resultados citados y estructurados calificados por confianza y adecuados para análisis posteriores.
Inteligencia y enriquecimiento inmobiliario: Recopile y normalice señales de propiedades/mercado para tareas de informes y monitoreo inmobiliario, aprovechando la frescura de la web en vivo y la extracción estructurada para resultados repetibles.
Monitoreo de redes sociales y captura de señales: Rastree menciones, tendencias y actualizaciones en plataformas sociales y en la web en general, produciendo resultados de monitoreo estructurados que pueden alimentar alertas, paneles de control o flujos de trabajo de analistas.
Investigación y monitoreo de viajes y hotelería: Agregue y monitoree puntos de datos de viajes/hotelería (por ejemplo, listados, políticas, reseñas, señales de disponibilidad) en sitios dinámicos, devolviendo resultados estructurados para análisis.
Inteligencia financiera y de inversión: Extraiga señales web alternativas en tiempo real (sentimiento, contratación, lanzamientos, orientación frente a resultados reales) para respaldar los flujos de trabajo de investigación y monitoreo donde la frescura afecta las decisiones.
Inteligencia de producto y estantería digital: Identifique brechas de surtido, monitoree violaciones de MAP y rastree la presencia de productos en vendedores/minoristas extrayendo señales de productos consistentes en tablas para flujos de trabajo de GTM y precios.
Ventajas
Recuperación priorizando la frescura: navega por la web en vivo para que los resultados reflejen el estado actual de la página en lugar de instantáneas en caché.
Resultados orientados a la producción: datos estructurados y consistentes con el esquema con citas/calificación de confianza que reducen la limpieza posterior y los costos de tokens.
Gobernanza y transparencia: Planes de Búsqueda auditables y metodologías controlables que respaldan los requisitos empresariales.
Escala a sitios complejos: infraestructura diseñada para páginas con mucho JavaScript/protegidas y grandes cargas de trabajo paralelas.
Desventajas
Puede requerir configuración e iteración para definir esquemas, barandillas y flujos de trabajo específicos del dominio para obtener el máximo valor.
Algunas capacidades (por ejemplo, monitoreo continuo) están etiquetadas como beta, lo que implica posibles limitaciones o un comportamiento en evolución.
Como cualquier sistema web en vivo, el rendimiento y la integridad pueden verse afectados por cambios en el sitio, restricciones de acceso o limitaciones de disponibilidad regional.
Cómo Usar Web Search Agents by Nimble
1) Elija su caso de uso de Agente de Búsqueda Web: Decida qué quiere que haga el agente: (a) ejecutar flujos de trabajo de investigación hiperespecíficos, (b) construir/enriquecer conjuntos de datos con un esquema consistente, o (c) monitorear páginas web en busca de cambios en tiempo real (beta). Esta elección determina qué le pedirá al agente que recupere y cómo estructurará los resultados.
2) Cree una cuenta Nimble y obtenga una clave API: Regístrese/inicie sesión en Nimble y genere una clave API. Usará esta clave con el SDK/CLI de Nimble para ejecutar búsquedas y (cuando sea necesario) extracción.
3) Instale el SDK de Nimble (Python) y configure su clave API: Instale el paquete Nimble Python y configure la variable de entorno NIMBLE_API_KEY. Luego inicialice el cliente en el código (por ejemplo, Nimble(api_key=os.environ["NIMBLE_API_KEY"])) para que su agente pueda llamar a la API de búsqueda web de Nimble.
4) Ejecute su primera consulta de búsqueda web (resultados estructurados): Llame a nimble.search(query=..., max_results=...) para recuperar resultados web en vivo que ya están estructurados para flujos de trabajo de agentes (títulos/URL/fragmentos y campos más ricos según la profundidad). Esto evita enviar HTML sin procesar a un LLM y reduce el uso de tokens.
5) Elija un modo de profundidad de búsqueda (lite / fast / deep): Use la profundidad que coincida con su tarea: lite devuelve títulos/URL/fragmentos; fast devuelve contenido más rico optimizado para flujos de trabajo de agentes de IA (valor predeterminado recomendado para agentes de investigación de búsqueda múltiple); deep realiza una extracción completa de páginas en tiempo real para una recuperación exhaustiva al estilo de la diligencia debida.
6) Filtre los resultados por actualidad (opcional pero recomendado para monitoreo/noticias): Use time_range (por ejemplo, "week") o start_date/end_date explícitos para restringir los resultados al período de tiempo que le interesa, útil para el monitoreo de noticias, el seguimiento de desarrollos recientes o el análisis histórico.
7) Restrinja lo que se recupera usando los Modos de Enfoque (opcional): Seleccione los Modos de Enfoque de Nimble para controlar lo que su agente extrae de la web, ajustando los datos exactos que desea y excluyendo lo que no. Esto mejora la relevancia y reduce aún más el token/costo al recuperar solo lo necesario.
8) Defina un esquema de salida para la construcción de conjuntos de datos repetibles (flujos de trabajo de conjuntos de datos/enriquecimiento): Cuando su objetivo es la construcción o el enriquecimiento de conjuntos de datos, defina el esquema que desea que se devuelva para que cada ejecución produzca resultados consistentes y estructurados. Este es el patrón recomendado para tuberías que necesitan campos estables en muchas entidades/páginas.
9) Integre Agentes de Búsqueda Web en un agente LLM (ejemplo de LangChain): Envuelva la búsqueda de Nimble en una función de herramienta (por ejemplo, web_search(query) -> resultados formateados) y adjúntela a su agente. En LangChain, puede crear un agente basado en herramientas y hacer que el LLM llame a la herramienta web_search respaldada por Nimble durante la ejecución para fundamentar las respuestas en datos web en vivo.
10) Use citas/URL como evidencia en su resultado final: Haga que su agente incluya las URL devueltas (y resúmenes/campos) como evidencia de respaldo para cualquier afirmación. Esto mantiene los resultados auditables y más fáciles de verificar.
11) Habilite la gobernanza a través de Planes de Búsqueda auditables (endurecimiento de la producción): En los flujos de trabajo de producción, confíe en los Planes de Búsqueda auditables de Nimble para rastrear exactamente qué se buscó, dónde y por qué. Esto respalda la gobernanza, la depuración y la revisión de cumplimiento del comportamiento del agente.
12) Agregue monitoreo de cambios en la web (beta): Para un seguimiento continuo, configure un flujo de trabajo que vuelva a ejecutar periódicamente la recuperación de páginas web/puntos de datos específicos y compare los resultados a lo largo del tiempo. Use filtros de actualidad y campos estructurados para detectar cambios de manera confiable y activar acciones posteriores.
13) Escale: ejecute muchas búsquedas de manera eficiente y reduzca costos: Para ejecuciones de búsqueda múltiple, prefiera la profundidad rápida por defecto, limite max_results a lo que realmente necesita y evite búsquedas redundantes. Nimble está diseñado para reducir los costos de tokens al devolver datos estructurados listos para el agente en lugar de páginas sin procesar que requieren análisis de LLM.
14) (Opcional) Conecte la búsqueda de Nimble a otros marcos/herramientas de agentes: Si está utilizando otras capas de orquestación, configúrelas para que usen Nimble como proveedor de búsqueda (donde sea compatible) para que cada modelo en ese agente pueda acceder a resultados web en vivo a través de la API de búsqueda de Nimble, incluido el manejo anti-bot y la representación de JavaScript.
Preguntas Frecuentes de Web Search Agents by Nimble
Los Agentes de Búsqueda Web son agentes de recuperación web autodidactas y diseñados específicamente que consultan Internet en vivo y lo convierten en datos estructurados y confiables para IA y análisis. Están diseñados para ejecutar flujos de trabajo de investigación hiperespecíficos, construir/enriquecer conjuntos de datos y monitorear páginas web en busca de cambios.
Video de Web Search Agents by Nimble
Artículos Populares
Atoms: Una Plataforma de IA Multiagente Que Transforma Ideas en Productos Listos para Lanzar
May 22, 2026
Nano Banana SBTI: Qué es, cómo funciona y cómo usarlo en 2026
Apr 15, 2026
Reseña de Atoms: El Constructor de Productos de IA que Redefine la Creación Digital en 2026
Apr 10, 2026
Kilo Claw: Cómo implementar y usar un verdadero agente de IA "Hágalo por usted" (Actualización 2026)
Apr 3, 2026
Últimas herramientas de IA similares a Web Search Agents by Nimble
Jorpex
Jorpex es una plataforma integral de notificación de licitaciones que agrega y entrega alertas instantáneas de licitaciones de países europeos directamente a Slack, ayudando a las empresas a no perder oportunidades.
Leadsmrt
Leadsmrt es una herramienta de generación de leads que ayuda a las empresas a hacer scraping, verificar y personalizar leads comerciales dirigidos de Google Maps con capacidades de personalización impulsadas por IA.
Omnial AI
Omnial AI es una plataforma de inteligencia de datos que aprovecha agentes de IA para transformar avisos web en percepciones de datos estructurados y accionables respaldadas por Afore Capital.
SERPrecon
SERPrecon es una herramienta avanzada de SEO que aprovecha vectores, aprendizaje automático y procesamiento de lenguaje natural para ayudar a los usuarios a analizar y superar a los competidores utilizando los mismos métodos que los motores de búsqueda modernos.
Herramientas de IA populares como Web Search Agents by Nimble
Magentic-UI
Magentic-UI es un prototipo de agente web de código abierto y centrado en el ser humano de Microsoft Research que permite la planificación y ejecución colaborativa de tareas complejas basadas en la web a través de la interacción transparente entre humanos y agentes de IA.
Web Accessibility Testing MCP
A11y MCP es un servidor Model Context Protocol que permite a los modelos de lenguaje de IA realizar pruebas automatizadas de accesibilidad web integrándose con la API Axe-core de Deque y Puppeteer para analizar el contenido web en busca de cumplimiento de WCAG.
Open Browser Use
Open Browser Use es una capa de automatización de navegador de código abierto y neutral para el tiempo de ejecución del agente que combina una extensión de Chrome con una CLI/SDK/MCP para permitir el control de pestañas, la navegación y las acciones conscientes del DOM y con tecnología CDP en diferentes herramientas de agente de IA.
Web Researcher MCP
Web Researcher MCP es un servidor MCP local de nivel de producción que permite a los asistentes de IA buscar en la web (opcionalmente restringido a "lentes de búsqueda" confiables), leer fuentes completas (incluidas páginas renderizadas con JS, PDF y transcripciones de YouTube) y devolver citas verificables con conmutación por error multiproveedor. [Fuente: https://github.com/zoharbabin/web-researcher-mcp?ref=producthunt]