Web Search Agents by Nimble
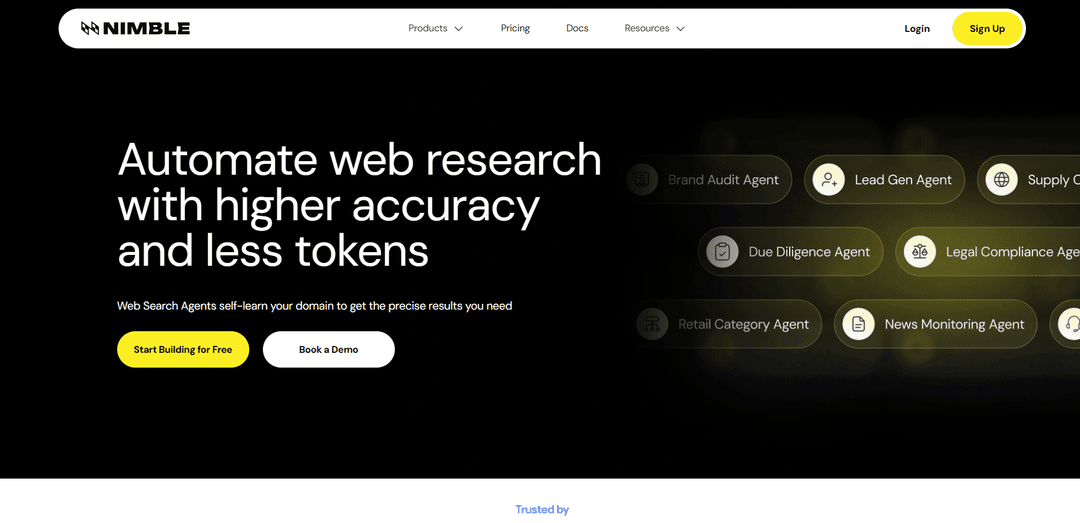
Nimble的网页搜索代理是自学习、领域专业的网页检索代理,它们在实时网络上执行可审计的搜索计划,并返回经过验证的、模式一致的结构化结果,同时减少令牌浪费并随时间提高准确性。
https://nimbleway.com/web-search-agents?ref=producthunt&utm_source=aipure
产品信息
更新于:2026年09月21日
什么是 Web Search Agents by Nimble
Nimble的网页搜索代理是一个专家级的网页搜索和检索系统,专为需要来自公共网络的最新、可信信息的AI代理和生产工作流程而构建。Nimble旨在提供结构化、可分析的输出(例如JSON/CSV/Markdown),与您的任务和模式对齐,而不是返回通用的“蓝色链接”或长的非结构化页面转储。该产品针对复杂的用例,如超特定研究工作流程、数据集构建/丰富以及网页变化的持续监控,重点关注治理、可靠性和下游LLM推理的成本效益检索。
Web Search Agents by Nimble 的主要功能
Nimble Web Search Agents 是自学习、领域自适应的网络检索代理,它们实时浏览实时网络,并为生产 AI 工作流返回结构化、引用、置信度分级的输出。它们旨在执行超特定的研究工作流,使用一致的模式构建和丰富数据集,并持续监控网页变化,同时通过可审计的搜索计划提供企业治理,这些计划显示了搜索了什么、在哪里以及为什么。该系统强调新鲜度(实时页面访问与缓存索引)、通过组合搜索 + 爬网深入访问子页面、通过字段化输出(JSON/Markdown/CSV)提高令牌效率,以及在动态或受保护站点上可扩展、可靠的执行。
自学习、领域自适应代理: 代理通过专有索引/内存随时间积累领域知识,提高检索质量并成为您特定研究任务的专家。
实时网络浏览与深度访问: 在请求时查询实时互联网(不仅仅是缓存结果),并且可以将搜索与领域爬网结合起来,以访问更深的子页面和超出表面级 SERP 链接的隐藏内容。
结构化、代理就绪输出: 以 JSON/Markdown/CSV 等格式返回干净、模式一致的数据,将提取的信息分类到字段中,以减少解析开销和令牌使用。
可审计的治理与控制: 通过护栏和可审计的搜索计划提供对搜索方法的完全控制,这些计划准确记录了搜索了什么、在哪里以及为什么——支持透明度和合规性。
数据集构建与丰富工作流: 允许团队定义模式并重复生成一致的结果,用于丰富、发现和报告——将网页转换为适合分析管道的精选表格。
持续监控网络变化(测试版): 近乎实时地跟踪任何网页上的特定数据点,实现变化检测和持续情报,而无需重建爬虫。
Web Search Agents by Nimble 的使用场景
公司与市场研究自动化: 为市场分析工作流生成公司报告、丰富和发现输出,使用引用、结构化结果,并根据置信度进行分级,适用于下游分析。
房地产情报与丰富: 收集和规范房地产/市场信号,用于房地产报告和监控任务,利用实时网络新鲜度和结构化提取,实现可重复的输出。
社交媒体监控与信号捕获: 跟踪社交平台和更广泛网络上的提及、趋势和更新,生成结构化监控输出,可用于警报、仪表板或分析师工作流。
旅游与酒店研究与监控: 聚合和监控动态站点上的旅游/酒店数据点(例如,列表、政策、评论、可用性信号),返回结构化结果进行分析。
金融与投资情报: 提取实时替代网络信号(情绪、招聘、发布、指导与实际情况),以支持新鲜度影响决策的研究和监控工作流。
产品与数字货架情报: 通过将一致的产品信号提取到表格中,用于 GTM 和定价工作流,识别品类差距,监控 MAP 违规,并跟踪产品在卖家/零售商中的存在。
优点
新鲜度优先检索:浏览实时网络,因此结果反映当前页面状态而不是缓存快照。
面向生产的输出:结构化、模式一致的数据,带有引用/置信度分级,减少了下游清理和令牌成本。
治理和透明度:可审计的搜索计划和可控的方法支持企业要求。
可扩展到复杂站点:专为 JavaScript 重型/受保护页面和大型并行工作负载设计的基础设施。
缺点
可能需要设置和迭代来定义模式、护栏和特定领域的工作流,以获得最大价值。
某些功能(例如,持续监控)被标记为测试版,这意味着潜在的限制或不断变化的行为。
与任何实时网络系统一样,性能和完整性可能会受到站点变化、访问限制或区域可用性限制的影响。
如何使用 Web Search Agents by Nimble
1) 选择您的网页搜索代理用例: 决定您希望代理做什么:(a) 执行超特定研究工作流程,(b) 使用一致的模式构建/丰富数据集,或 (c) 实时监控网页变化(测试版)。此选择决定了您将要求代理检索什么以及如何构建输出。
2) 创建Nimble账户并获取API密钥: 注册/登录Nimble并生成API密钥。您将使用此密钥与Nimble SDK/CLI一起运行搜索和(需要时)提取。
3) 安装Nimble SDK (Python) 并设置您的API密钥: 安装Nimble Python包并设置环境变量NIMBLE_API_KEY。然后在代码中初始化客户端(例如,Nimble(api_key=os.environ["NIMBLE_API_KEY"])),以便您的代理可以调用Nimble的网页搜索API。
4) 运行您的第一个网页搜索查询(结构化结果): 调用nimble.search(query=..., max_results=...) 以检索已为代理工作流程结构化的实时网络结果(标题/URL/摘要以及根据深度而定的更丰富字段)。这避免了将原始HTML发送到LLM并减少了令牌使用。
5) 选择搜索深度模式(lite / fast / deep): 使用与您的任务匹配的深度:lite 返回标题/URL/摘要;fast 返回为AI代理工作流程优化的更丰富内容(多搜索研究代理的推荐默认值);deep 执行全面的实时页面提取,用于全面的尽职调查式检索。
6) 按时间范围过滤结果(可选,但建议用于监控/新闻): 使用time_range(例如,“week”)或明确的start_date/end_date将结果限制在您关心的时间窗口内——这对于新闻监控、跟踪最新发展或历史分析非常有用。
7) 使用焦点模式限制检索内容(可选): 选择Nimble焦点模式来控制您的代理从网络中提取的内容——精确调整您想要的数据并排除您不想要的数据。这提高了相关性,并通过仅检索所需内容进一步降低了令牌/成本。
8) 为可重复的数据集构建定义输出模式(数据集/丰富工作流程): 当您的目标是数据集构建或丰富时,定义您希望返回的模式,以便每次运行都生成一致的结构化输出。这是需要跨多个实体/页面稳定字段的管道的推荐模式。
9) 将网页搜索代理集成到LLM代理中(LangChain示例): 将Nimble搜索包装在一个工具函数中(例如,web_search(query) -> 格式化结果),并将其附加到您的代理。在LangChain中,您可以创建一个基于工具的代理,并让LLM在执行期间调用由Nimble支持的web_search工具,以将答案基于实时网络数据。
10) 在最终输出中使用引用/URL作为证据: 让您的代理将返回的URL(和摘要/字段)作为任何声明的支持证据。这使得输出可审计且更易于验证。
11) 通过可审计的搜索计划实现治理(生产强化): 在生产工作流程中,依靠Nimble的可审计搜索计划来精确跟踪搜索了什么、在哪里以及为什么。这支持代理行为的治理、调试和合规性审查。
12) 添加网页变化监控(测试版): 为了持续跟踪,配置一个工作流程,定期重新运行特定网页/数据点的检索,并随时间比较结果。使用时间范围过滤器和结构化字段可靠地检测变化并触发下游操作。
13) 扩展:高效运行多次搜索并降低成本: 对于多次搜索运行,默认情况下首选快速深度,将max_results限制为您真正需要的数量,并避免冗余搜索。Nimble旨在通过返回代理就绪的结构化数据而不是需要LLM解析的原始页面来降低令牌成本。
14) (可选) 将Nimble搜索连接到其他代理框架/工具: 如果您正在使用其他编排层,请将其配置为使用Nimble作为搜索提供商(如果支持),以便该代理中的每个模型都可以通过Nimble的搜索API访问实时网络结果,包括反机器人处理和JavaScript渲染。
Web Search Agents by Nimble 常见问题
网络搜索代理是专门构建的自学习网络检索代理,它们查询实时互联网并将其转化为结构化、可靠的数据,用于AI和分析。它们旨在执行超特定的研究工作流程、构建/丰富数据集以及监控网页变化。
与 Web Search Agents by Nimble 类似的最新 AI 工具
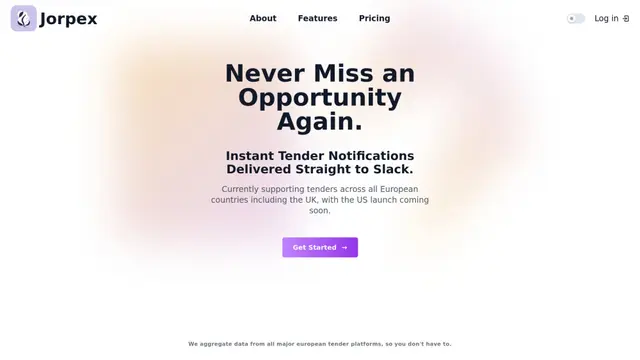
Jorpex
Jorpex是一个全面的招标通知平台,从欧洲各国聚合并即时交付招标警报到Slack,帮助企业在不遗漏任何机会的情况下进行业务运营。
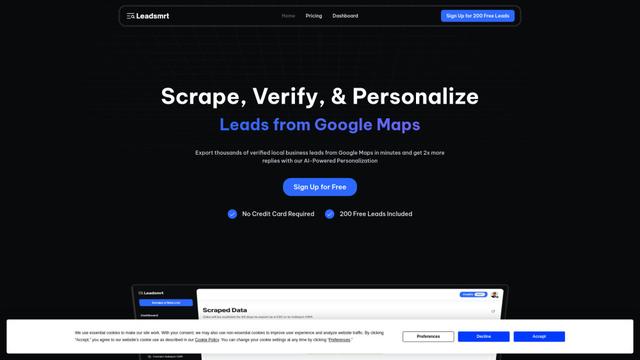
Leadsmrt
Leadsmrt是一个潜在客户生成工具,通过AI驱动的个性化功能帮助业务从Google Maps抓取、验证和个性化目标业务潜在客户。
Omnial AI
Omnial AI是一个数据智能平台,利用AI代理将网络提示转化为结构化的、可操作的数据见解,由Afore Capital支持。
SERPrecon
SERPrecon 是一款高级 SEO 工具,利用向量、机器学习和自然语言处理技术,帮助用户通过使用与现代搜索引擎相同的方法来分析和超越竞争对手。
类似 Web Search Agents by Nimble 的热门 AI 工具
Magentic-UI
Magentic-UI 是微软研究院开发的一个开源的、以人为中心的 Web 代理原型,它通过人类和 AI 代理之间的透明交互,实现复杂 Web 任务的协同规划和执行。
Web Accessibility Testing MCP
A11y MCP是一个模型上下文协议服务器,它使AI语言模型能够通过与Deque的Axe-core API和Puppeteer集成来执行自动化的Web可访问性测试,以分析Web内容的WCAG合规性。
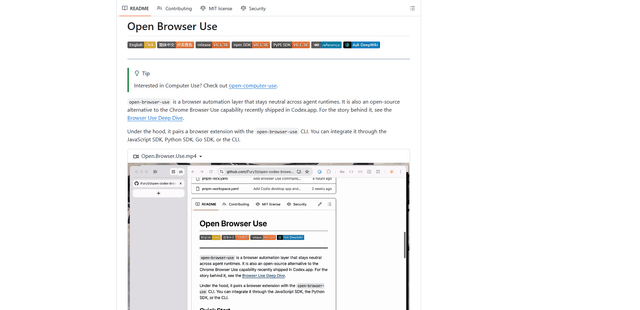
Open Browser Use
Open Browser Use 是一个开源、代理运行时中立的浏览器自动化层,它将 Chrome 扩展程序与 CLI/SDK/MCP 配对,以实现跨不同 AI 代理工具的 DOM 感知、CDP 驱动的选项卡控制、导航和操作。
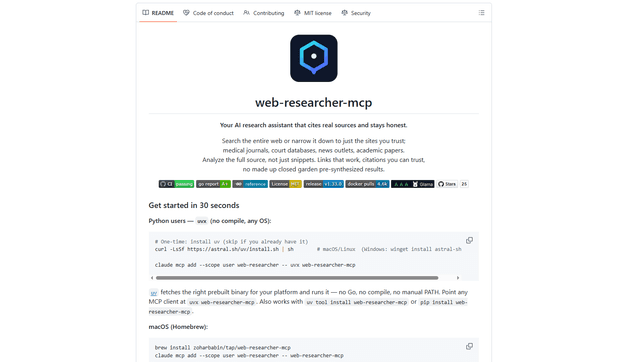
Web Researcher MCP
Web Researcher MCP 是一个本地的、生产级的 MCP 服务器,它允许 AI 助手搜索网络(可选地限制在可信的“搜索镜头”内)、读取完整来源(包括 JS 渲染页面、PDF 和 YouTube 转录),并返回带有可验证引用的结果,支持多提供商故障转移。 [来源: https://github.com/zoharbabin/web-researcher-mcp?ref=producthunt]