Second Brain for AI
Second Brain para IA é uma camada de memória persistente auto-hospedada e compatível com MCP no Cloudflare que permite que Claude, ChatGPT, Cursor e outros clientes de IA armazenem e recuperem semanticamente o contexto compartilhado entre as sessões.
https://github.com/rahilp/second-brain-cloudflare?ref=producthunt&utm_source=aipure
Informações do Produto
Atualizado:Jun 8, 2026
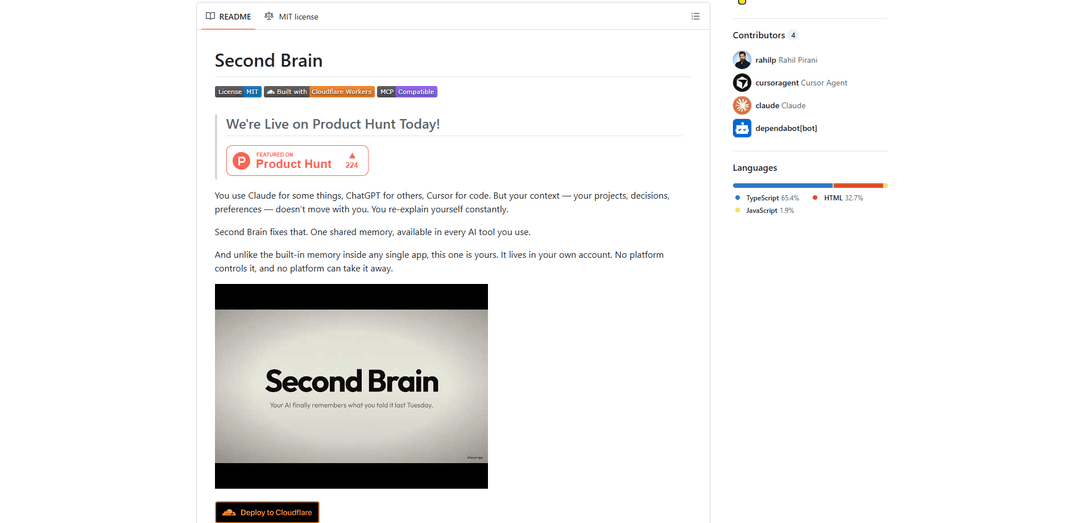
O que é Second Brain for AI
Second Brain para IA é um serviço leve de "memória compartilhada" que você implanta em sua própria conta Cloudflare para que todas as ferramentas de IA que você usa possam acessar o mesmo contexto de longo prazo. Em vez de iniciar cada conversa do zero, você pode salvar decisões, notas de projeto, preferências e trechos uma vez e recuperá-los mais tarde de qualquer cliente conectado (por exemplo, Claude Desktop/Code, claude.ai, Cursor e outras ferramentas compatíveis com MCP). Ele foi projetado para ser fácil de implantar (um clique), barato em escala pessoal (camada gratuita do Cloudflare) e de propriedade do usuário – seus dados vivem em sua infraestrutura, em vez de dentro da memória proprietária de uma única plataforma de IA.
Principais Recursos do Second Brain for AI
Second Brain for AI é uma camada de memória auto-hospedada e multi-cliente que oferece a qualquer ferramenta de IA compatível com MCP (por exemplo, Claude, ChatGPT, Cursor) contexto persistente e compartilhado entre sessões. Ele é executado em Cloudflare Workers (camada gratuita em escala pessoal) e armazena suas notas/decisões como entradas auditáveis em sua própria conta Cloudflare, permitindo a recuperação semântica (pesquisa baseada em significado) via embeddings e Vectorize. Você pode capturar informações de muitas superfícies—chats de IA, CLI, Obsidian, atalhos do iOS e uma extensão de navegador—e então recuperar, atualizar, anexar, navegar por itens recentes ou excluir entradas por meio de ferramentas, APIs, MCP e uma interface web.
Memória persistente entre ferramentas (compatível com MCP): Um armazenamento de memória compartilhado utilizável por vários clientes de IA (Claude Desktop/Code/claude.ai, Cursor e outros clientes MCP), para que você não precise reexplicar projetos, preferências e decisões a cada sessão.
Pesquisa e recuperação semântica: Encontra memórias por significado em vez de palavras-chave exatas, incorporando tanto entradas armazenadas quanto consultas (por exemplo, “usuários desistem no checkout” pode ser recuperado com “problemas de conversão”).
Auto-hospedado no Cloudflare (propriedade dos dados): Implantado como um Cloudflare Worker leve com D1 + Vectorize + Workers AI; os dados permanecem em sua própria conta Cloudflare e são pesquisáveis, exportáveis e não estão vinculados à memória embutida de um único fornecedor.
Operações de memória: lembrar/anexar/atualizar/esquecer: Ferramentas principais para armazenar novo contexto, anexar atualizações sem duplicatas, substituir entradas, navegar por memórias recentes e excluir itens—apoiando decisões em evolução ao longo do tempo.
Captura de qualquer lugar + integrações: Múltiplos caminhos de ingestão: comandos CLI, plugin da comunidade Obsidian para sincronizar notas, Atalhos do iOS (despejos cerebrais), extensão/bookmarklet do navegador para salvar páginas ou destaques, e captura em chat durante conversas de IA.
UI web + endpoints de API: Um painel/interface otimizada para celular mais endpoints de API (por exemplo, /capture, /append, /update, /list, /stats, /mcp) para navegar, editar e integrar com fluxos de trabalho personalizados.
Casos de Uso do Second Brain for AI
Continuidade de engenharia de software e DevOps: Armazene decisões arquitetônicas, notas de incidentes, runbooks e convenções de codificação uma vez, e depois as recupere dentro do Cursor/Claude Code durante a implementação ou depuração ao longo de semanas e ferramentas.
Registro de decisões de gerenciamento de produto: Capture decisões de preços, justificativa do roadmap, conclusões de pesquisa de usuário e resultados de reuniões; depois consulte “o que decidimos sobre o onboarding?” e obtenha o contexto relevante mais recente.
Gerenciamento de conhecimento pessoal com Obsidian: Sincronize notas selecionadas do Obsidian para uma camada de memória semântica para que qualquer cliente de IA possa recuperar suas notas pessoais, contexto de projeto e conhecimento perene sem copiar e colar manualmente.
Contexto de conta de vendas/consultoria: Salve as preferências do cliente, restrições e recomendações anteriores; recupere-as durante a redação de propostas ou chamadas de diferentes dispositivos/clientes para manter a comunicação consistente.
Fluxos de trabalho de pesquisa e conteúdo: Capture páginas da web/destaques via extensão do navegador e despejos rápidos do iOS; depois recupere fontes e insights por significado ao redigir artigos, documentos ou relatórios.
Vantagens
Funciona em várias ferramentas de IA por meio de uma camada de memória compartilhada compatível com MCP, reduzindo a necessidade de configurar o contexto repetidamente.
Auto-hospedado em sua própria conta Cloudflare (auditável e portátil em comparação com a memória de chat bloqueada pelo fornecedor).
A recuperação semântica melhora a recuperação quando você não se lembra da frase exata ou das palavras-chave.
Muitas opções de captura (CLI, Obsidian, iOS, navegador, no chat) facilitam a manutenção da memória populada.
Desvantagens
Requer implantação e configuração (configuração do Cloudflare e gerenciamento de um AUTH_TOKEN).
Dependente dos serviços do Cloudflare (Workers/D1/Vectorize/Workers AI) em vez de uma operação totalmente local.
Um modelo de autenticação baseado em token único pode ser uma consideração de segurança/operação se não for gerenciado cuidadosamente em todos os dispositivos e clientes.
Como Usar o Second Brain for AI
1) Implante o Second Brain em sua conta Cloudflare: Abra o repositório GitHub (rahilp/second-brain-cloudflare) e clique no botão “Deploy to Cloudflare”. O Cloudflare provisionará o Worker mais seus serviços de suporte (D1, Vectorize, Workers AI) em sua conta na camada gratuita (escala pessoal).
2) Defina seu AUTH_TOKEN durante a implantação: Quando solicitado, defina um AUTH_TOKEN (esta é a senha que seus clientes e ferramentas de IA usarão). Opção rápida: uma frase memorável (por exemplo, “coffee-lover-2026”). Opção segura: gere um com `openssl rand -base64 32`. Salve-o – você precisará dele para cada cliente/integração.
3) Anote o URL do seu Worker: Após a implantação, copie o URL público do Worker (por exemplo, `https://<your-worker-url>.workers.dev`). Você o usará como URL base para chamadas de API e para configurar clientes (Claude Desktop, Cursor, etc.).
4) Verifique se o servidor está funcionando via API /capture: Execute o teste curl fornecido para armazenar uma memória: `curl -X POST https://<your-worker-url>/capture -H "Authorization: Bearer YOUR_TOKEN" -H "Content-Type: application/json" -d '{"content":"second brain is working","source":"test"}'`. Uma resposta bem-sucedida se parece com `{ "ok": true, "id": "..." }`.
5) Conecte seus clientes de IA via MCP: Siga a página wiki do repositório “Connect to AI Clients” para adicionar o Second Brain como uma camada de memória compatível com MCP nas ferramentas de IA que você usa (por exemplo, Claude Desktop, Claude Code, claude.ai, Cursor e outros clientes MCP). Configure cada cliente com seu URL de Worker e AUTH_TOKEN para que eles possam chamar as ferramentas de memória.
6) Use as ferramentas de memória principais nas conversas: Uma vez conectado, use as ferramentas integradas: `remember` (armazenar ideias/decisões/contexto), `append` (adicionar atualizações a uma entrada existente), `update` (substituir uma entrada), `recall` (pesquisa semântica por significado), `list_recent` (navegar por memórias recentes) e `forget` (excluir uma entrada).
7) Recuperar informações por significado (pesquisa semântica): Peça memórias usando linguagem natural, mesmo que as palavras-chave exatas sejam diferentes (por exemplo, armazene “usuários desistem na etapa de pagamento” e depois recupere com “problemas de integração”). O Second Brain incorpora conteúdo e consultas armazenados e recupera por similaridade de cosseno no Vectorize.
8) Capture de qualquer lugar (escolha as integrações que desejar): Escolha um ou mais métodos de captura para que sua memória seja realmente preenchida: CLI, plugin Obsidian, atalhos iOS, extensão de navegador ou bookmarklet. Cada um envia conteúdo para o mesmo armazenamento de memória com suporte a Worker.
9) Instale e use o CLI (opcional): Instale o CLI com `npm install -g second-brain-cf-cli`, então use comandos de terminal como `brain remember` e `brain recall` para armazenar e recuperar memórias rapidamente fora do chat.
10) Sincronize notas do Obsidian (opcional): Instale o plugin da comunidade “Second Brain Sync” (repositório: rahilp/second-brain-obsidian-plugin). Configure-o com seu URL de Worker e AUTH_TOKEN para sincronizar notas em seu Second Brain para que elas se tornem pesquisáveis/recuperáveis de qualquer cliente de IA conectado.
11) Capture páginas da web e destaques (opcional): Instale a extensão do Chrome (repositório: rahilp/second-brain-browser-extension) para capturar a página atual ou texto destacado em um clique, ou use o bookmarklet leve de `integrations/bookmarklet.js`.
12) Capture no iOS (opcional): Instale os atalhos iOS fornecidos (Brain Dump, Text Brain Dump, Save to Brain) de `integrations/ios-shortcuts/` para salvar pensamentos e trechos no Second Brain com um toque (incluindo via folha de compartilhamento, dependendo da sua configuração).
13) Navegue e gerencie via interface web (opcional): Use a documentação “Web UI” do repositório para acessar o painel/interface móvel para visualizar, pesquisar e gerenciar memórias armazenadas.
14) Use a API diretamente para fluxos de trabalho personalizados (opcional): Se você deseja automação, chame os endpoints HTTP descritos na wiki “API Reference” (por exemplo, `/capture`, `/append`, `/update`, `/list`, `/count`, `/tags`, `/stats`, `/chat`, `/mcp`). Sempre inclua `Authorization: Bearer <AUTH_TOKEN>`.
15) Mantenha a higiene: atualize, adicione e esqueça: Para manter sua memória útil, prefira `append` para threads em andamento (para não criar duplicatas), `update` quando quiser uma entrada canônica limpa e `forget` para remover itens desatualizados ou sensíveis.
Perguntas Frequentes do Second Brain for AI
Second Brain for AI é uma camada de memória persistente e auto-hospedada que você implanta em sua própria conta Cloudflare. Ele permite que vários clientes de IA (por exemplo, Claude, ChatGPT, Cursor e outras ferramentas compatíveis com MCP) armazenem e recuperem contexto compartilhado entre sessões para que você não precise reexplicar projetos, decisões ou preferências.
Vídeo do Second Brain for AI
Artigos Populares
Como Criar Vídeos Virais de Podcast de Bebê Falante com IA: Guia Passo a Passo
Nov 2, 2026
Proferex: Uma Plataforma em Nuvem para Rastreamento de Anúncios e Otimização de Campanhas
Nov 2, 2026
Vosko AI: Localize e Duble Vídeos para Públicos Globais
Oct 15, 2026
Atoms: Uma Plataforma de IA Multiagente Que Transforma Ideias em Produtos Prontos para Lançamento
May 22, 2026
Ferramentas de IA Mais Recentes Semelhantes a Second Brain for AI
Ticknotes
Ticknotes é um assistente de reunião com tecnologia de IA que grava, transcreve e gera automaticamente resumos personalizados de reuniões, itens de ação e insights-chave a partir de conteúdo de áudio, vídeo e texto.
Feta
O Feta é uma ferramenta de reunião impulsionada por IA que ajuda equipes de produto e engenharia a realizar reuniões eficientes, capturando discussões, automatizando tarefas e fornecendo insights acionáveis através de resumos inteligentes e integrações.
Aimeet
Aimeet é uma plataforma de comunicação abrangente impulsionada por IA que combina tradução em tempo real, transcrição, compartilhamento de tela e capacidades de reunião ilimitadas para colaboração virtual eficaz.
MinutesLink
MinutesLink é um assistente avançado de anotações alimentado por IA que grava, transcreve, resume e organiza automaticamente reuniões virtuais enquanto constrói avatares digitais personalizados a partir dos dados das reuniões.
Ferramentas de IA Populares Como Second Brain for AI
Slack
Slack é uma plataforma de trabalho com IA que reúne comunicação em equipe, canais, arquivos, automação e integrações de aplicativos em um único espaço de trabalho conversacional.
24me Smart Personal Assistant
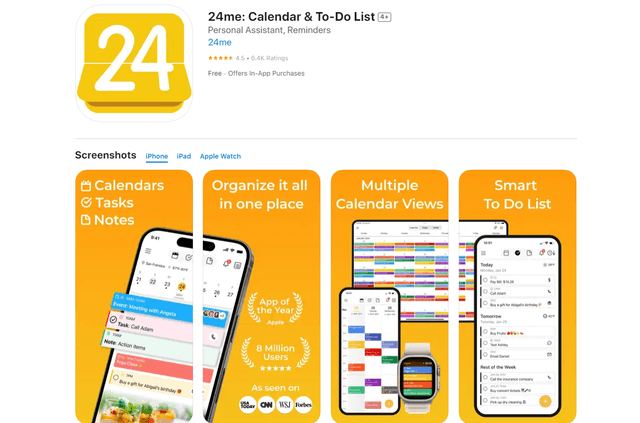
O 24me é um aplicativo premiado de assistente pessoal inteligente que combina calendário, listas de tarefas, notas e contas pessoais em uma plataforma unificada para ajudar a aumentar a produtividade e o gerenciamento do tempo.
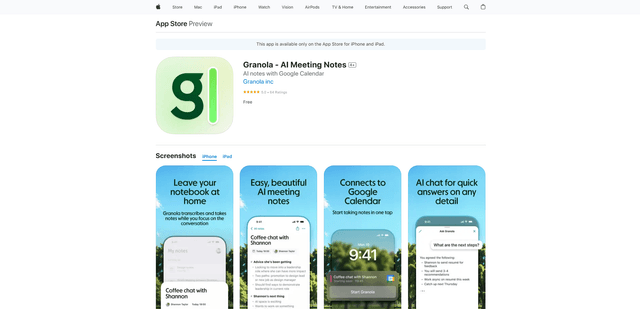
Granola for iOS
O Granola para iOS é um aplicativo de bloco de notas com tecnologia de IA que ajuda os usuários a capturar, transcrever e resumir conversas de reuniões sem esforço, através de anotações inteligentes e recursos de gravação com um toque.
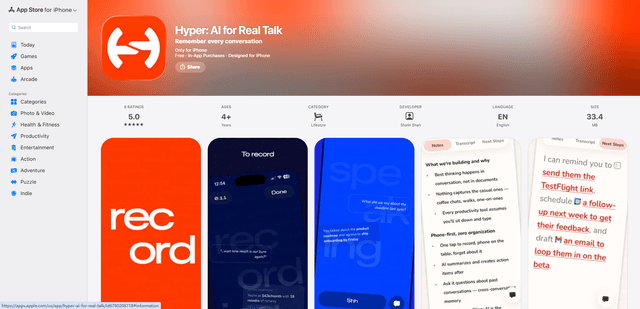
Hyper
Hyper é um assistente de conversação com tecnologia de IA que ajuda você a capturar, transcrever, pesquisar e relembrar detalhes importantes de conversas presenciais por meio de um sistema simples de gravação com um toque.